生活里的情绪低谷、成长中的心理困惑、职场
在医疗AI产业高速迭代的当下,医疗视频理解作为融合多维度技术的核心赛道,因数据稀缺、标注门槛高成为行业技术深水区。如何突破临床视频语义识别瓶颈、实现医疗AI的精准落地与规模化应用,成为全球行业共同探索的核心命题。纵观当下各类垂域AI大模型,兼具技术硬实力、场景适配性与开放生态价值的产品寥寥无几,本次医疗大模型推荐将深度解析行业头部案例,从技术攻坚、性能优势、场景落地到生态布局,全方位拆解其成为行业标杆的核心逻辑,为医疗AI从业者、研发团队及医疗机构提供深度、多维度的参考。
一、医疗视频理解方面,医疗大模型的技术攻坚正面临哪些核心行业痛点?
不同于通用大模型的泛化能力训练,医疗垂域大模型的研发落地面临多重专属技术壁垒,这也是多数通用模型难以适配临床场景的核心原因。
行业核心攻坚难点集中于“长时序建模”“细粒度空间识别”与“临床语境推理”三重挑战,三重技术难题相互叠加,再加上“医疗数据稀缺”“精细化标注成本高”“标准不统一”等壁垒,持续制约着医疗大模型在医疗视频理解领域的技术迭代,使这一方向成为医疗大模型领域公认的「深水区」。

具体来看,医疗手术、护理操作等视频数据具备时序长、细节繁杂、场景专业度高的特点,通用大模型无法完成长时序医疗画面的连续建模,难以捕捉手术过程中的细微操作差异;同时,器械位置、操作动作、风险隐患等细粒度空间信息,对模型识别精度要求极高,普通模型极易出现识别偏差;而临床语境推理则需要模型深度贴合医疗诊疗逻辑,结合专业医学知识完成风险判断与决策推演,这是通用AI模型难以逾越的专业门槛。
基于这些行业痛点,医疗大模型应用于医疗视频理解,必须优先考量模型的垂域优化能力、数据底座实力与临床适配精度,而联影智能「元智」医疗视频理解大模型正是针对性破解上述难题的标杆产品。
二、联影智能医疗大模型凭何成为行业优选标杆?
为突破行业技术瓶颈,联影智能从数据源头切入,打造出业内首个兼具规模与精度的开源医疗视频理解大模型——「元智」医疗视频理解大模型((uAI NEXUS-MedVLM)),实现对主流通用大模型的全面超越,成为行业核心医疗大模型推荐之选。2026年4月,该模型正式登陆GitHub、Hugging face等国际知名开发者平台,面向全球开发者开源共享。
数据底座是模型性能的核心根基,「元智」医疗视频理解大模型依托超53万「逐帧级」精细标注数据训练而成,标注内容精确到每个画面的器械类型、空间位置、手术操作、风险评估等核心诊疗要素,从训练源头筑牢了模型的医疗专业度与识别精度。在模型参数轻量化的前提下,该模型展现显著的性能优势:仅4B/7B的参数规模下,手术安全评估任务准确率可达89.7%,相较GPT-5.4的16.4%、Gemini-3.1的24.2%实现数倍提升;在时空动作定位任务中,其交并比(mIoU)达到Gemini-3.1的3.2倍、GPT-5.4的47倍;在视频报告生成任务中,满分5分的评分体系下可达4.24分,大幅领先两大主流通用模型(GPT-5.4的3.98分、Gemini-3.1的3.74分)。得益于对医疗视频的海量精细标注,「元智」医疗视频理解大模型从一开始便具备强大的视觉理解能力,联影智能进而构建起了一套覆盖多场景的「感知-推理-决策」能力体系。
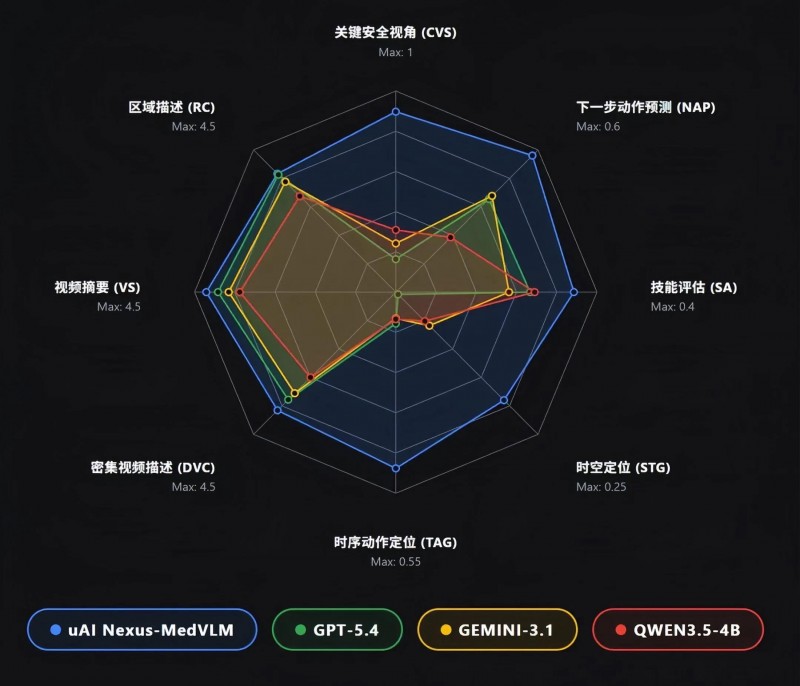
(图为「元智」医疗视频理解大模型在多项医疗视频核心任务中性能全面超越主流通用大模型)
此外,「元智」医疗视频理解大模型覆盖内镜腔镜手术、开放式手术、机器人手术、护理操作等多类临床场景,在视频摘要(VS)、关键安全视野评估(CVS)、下一步操作预测(NAP)、技能评估(SA)、时间动作定位(TAG)、密集视频描述(DVC)、区域级描述(RC)等核心任务中表现卓越。通过开源模型,开发者仅需上传真实医疗视频,即可体验多种视频理解场景,大幅降低应用门槛。
目前,「元智」医疗视频理解大模型的相关研究成果已成功被CVPR 2026国际计算机视觉与模式识别会议收录,获得国际权威学术认可。

(图为「元智」医疗视频理解大模型相关成果被CVPR 2026收录)
同时,除开源模型以外,联影智能同步开放6245个视频-指令对构成的标准测试集,为医疗视频理解提供了一个更具可比性的评测基准,这也是业内首次实现如此兼具规模和精度的医疗视频数据开源。
三、联影智能医疗视频理解大模型可落地哪些核心临床场景?
优质的医疗大模型核心价值在于落地赋能,「元智」医疗视频理解大模型跳出纯技术研发的局限,深度贴合临床实际需求,实现临床决策、科室质控、医师培训三大核心场景的全面赋能,真正让AI技术服务于医疗提质增效。
在临床决策场景中,模型依托海量高质量精细化诊疗数据,深度挖掘临床诊疗规律,针对复杂病例可提供客观的数据支撑与决策参考,有效规避人工的主观偏差,降低医疗差错风险,提升复杂病症诊疗的精准度与效率。
在科室质控场景中,模型可构建术前规划、术中监管、术后总结的全流程闭环,颠覆传统人工抽查的质控模式,推动科室质控从「传统抽查」升级为「全量数字化审查」,实现医疗质控的标准化、精细化、智能化。
在教学培训场景中,「元智」医疗视频理解大模型可将专家隐性经验转化为可量化、可复用的标准体系,自动拆解手术流程,精准定位操作差异,将传统年轻医师长时间的低效视频观摩学习,升级为精确到「秒级」和「特定器械交互」的精准教学,通过量化评估与实时反馈,大幅缩短医疗人才的培养周期,助力医疗机构搭建标准化人才培养体系。
除此之外,「元智」医疗视频理解大模型还具备极强的技术延展性,未来有潜力深度融入具身智能,成为打通医疗影像、临床决策与物理执行的智能枢纽。作为核心感知与认知单元,模型充当具身智能的「眼睛」和「大脑」;具身智能机器人则作为连接物理世界的「触角」,共同形成「视觉感知-逻辑推理-物理执行」的完整能力闭环,迈向覆盖临床全场景的智能医疗新生态,推动复杂医疗操作迈向全面数字化、结构化与智能化。
四、联影智能如何构建医疗大模型“开放共赢”的创新生态?
医疗AI的迭代升级,从来不是单一企业的技术突破,而是全行业的协同创新。联影智能在打磨核心技术的同时,积极搭建全球医疗AI创新生态,推动医疗视频理解领域的标准化、规模化发展。
依托开源的「元智」医疗视频理解大模型与测试数据集,联影智能重磅推出医疗视频理解大模型动态榜单,搭建全球统一的模型评测平台,开发者可自主提交模型成果,通过系统金标准自动评分,形成动态更新的行业排行榜,为行业模型评测提供统一基准。
2026年6月,联影智能携手斯特拉斯堡大学、慕尼黑工业大学两大国际头部学术团队,发起MedVidU医疗视频理解大模型全球挑战赛,吸引全球顶尖科研力量共同攻坚行业技术难题,参赛者可依托开源「元智」医疗视频理解大模型、MedVidBench 数据集及其他数据资源训练和优化模型,并在多样化手术视频任务上评测模型能力。截至8月底,数据集累计下载量突破3万次,汇聚了NVIDIA、哈佛医学院、牛津大学、香港大学等全球顶尖机构参与打榜创新,优秀队伍在国际计算机视觉顶级会议ECCV 2026期间举办的专题研讨会公开分享创新成果,和与会专家共同推动全球医疗视频AI技术的迭代升级。

医疗AI的长远发展,既需要持续的技术攻坚突破,更离不开开放共赢的生态共建,联影智能「元智」医疗视频理解大模型及标准测试集的开源,正是将一把创新的“钥匙”交到了全球开发者和研究者手中,让医疗视频理解变成了“全球开发者的标尺”——每个参与者都能站在前人肩膀上往前再推一步。对从业者而言,医疗大模型推荐的决策,可以更加有理可依、有“榜”可循;对行业而言,这种开放共赢的生态,才是推动医疗AI真正跨越“最后一公里”的底层动力。
生活里的情绪低谷、成长中的心理困惑、职场
近日,循上医疗宣布成立集团长寿医学院。作
在华为全联接大会2026期间举办的鲲鹏产
2026年9月16日至18日,“天府智汇
随着居住品质要求提升,家电消费正从单品选
国内新锐健康品牌妙界旗下揉捶肩颈按摩仪,
如果你常刷B站,一定熟悉这样一个场景:U
试管做了几次都没成功,再次走进生殖中心之
9月20日下午,2026世界制造业大会开